Em fevereiro de 2019, o Google anunciou que um novo conjunto de modelos de machine learning, construído com a biblioteca TensorFlow, passou a barrar cerca de 100 milhões de mensagens de spam a mais por dia no Gmail. Somados a outras proteções, esses modelos bloqueavam mais de 99,9% do spam, phishing e malware, segundo a empresa. Ninguém escreveu uma regra para cada golpe: os modelos aprenderam com exemplos.
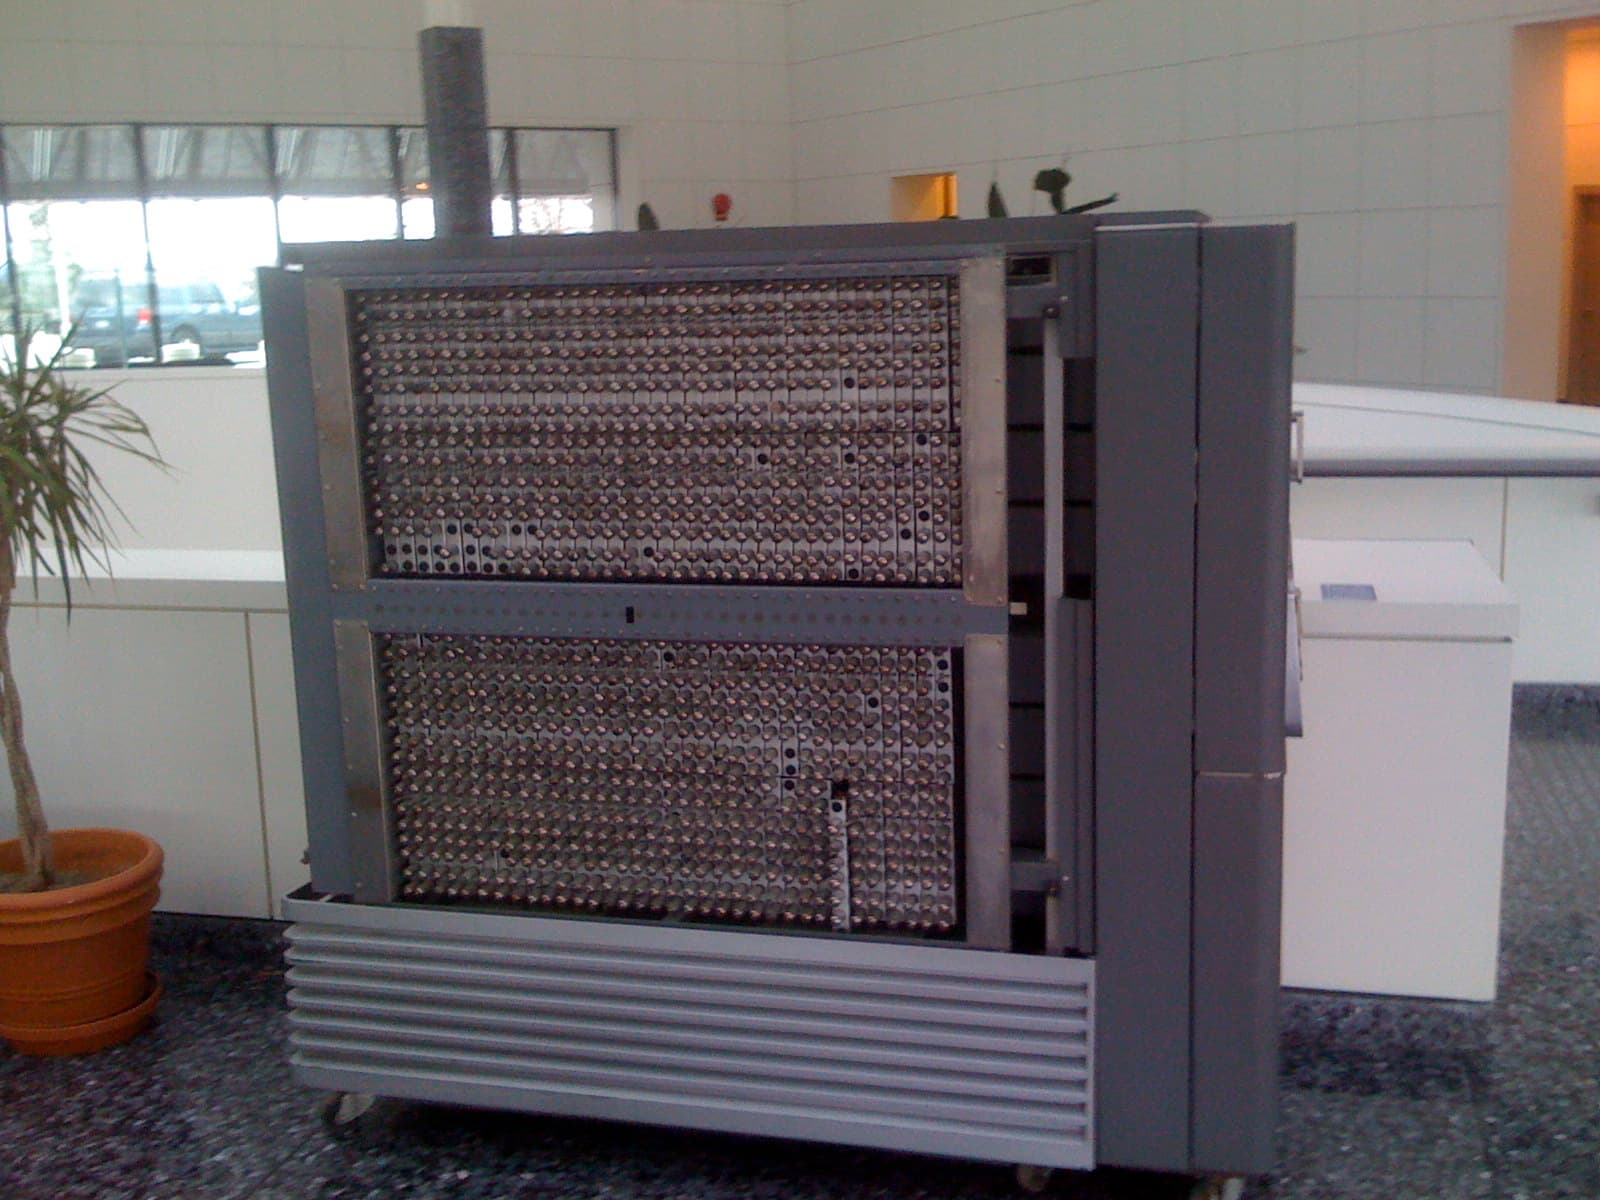
Essa é a ideia do machine learning, ou aprendizado de máquina: em vez de programar todas as regras, você fornece dados e deixa um algoritmo encontrar o padrão. O termo foi cunhado por Arthur Samuel, pesquisador da IBM, para descrever seu programa de damas que melhorava jogando contra si mesmo no computador IBM 701, o da foto acima. Em 1962, depois de milhares de partidas, o programa venceu o jogador Robert Nealey, segundo a IBM.
Abaixo, as etapas de um projeto de machine learning, usando um filtro de spam como fio condutor. Para o panorama geral da área, veja o que é inteligência artificial.
Etapa 1: decidir se o problema precisa de machine learning
O guia Rules of Machine Learning, publicado pelo Google para desenvolvedores, começa com uma regra que surpreende: "não tenha medo de lançar um produto sem machine learning". Sem dados suficientes, regras simples escritas à mão (heurísticas) costumam levar o produto boa parte do caminho.
Um teste prático:
| Situação | Melhor caminho |
|---|---|
| A regra é conhecida e fechada (validar CPF, calcular imposto) | Programação tradicional |
| A regra existe, mas tem dezenas de exceções e muda sempre | Machine learning |
| Há muitos exemplos com a resposta certa (e-mails marcados como spam) | Machine learning supervisionado |
| Não há dados nem forma de medir acerto | Comece coletando dados; o modelo vem depois |
O filtro de spam passa no teste: os golpes mudam o tempo todo, e os próprios usuários geram rótulos quando clicam em "denunciar spam".
Etapa 2: definir a métrica antes do modelo
A segunda regra do mesmo guia é "primeiro, desenhe e implemente métricas". Em spam, dois erros têm custos diferentes:
- Falso positivo: um e-mail legítimo, como um boleto, vai para a pasta de spam. Custa caro para o usuário.
- Falso negativo: um golpe chega à caixa de entrada. Custa caro também, de outro jeito.
Daí vêm as duas métricas mais usadas em classificação. Precisão responde: dos e-mails que o modelo marcou como spam, quantos eram spam? Recall responde: de todo o spam que chegou, quanto o modelo pegou? Subir uma costuma baixar a outra, e a escolha do ponto de equilíbrio é uma decisão de produto, não só técnica.
A acurácia sozinha engana. Se só 1% das transações de um banco são fraude, um modelo que nunca aponta fraude acerta 99% das vezes e não serve para nada.
Etapa 3: reunir e preparar os dados
Cada exemplo é descrito por características (features). Para um e-mail: remetente, domínio, horário, presença de links, palavras do assunto, se o remetente já trocou mensagens com o destinatário. A resposta esperada, "spam" ou "não spam", é o rótulo.
Os dados são divididos em três partes que não se misturam:
- Treino: onde o modelo ajusta seus parâmetros.
- Validação: onde se comparam versões e configurações.
- Teste: a prova final, usada uma única vez, com dados que o modelo nunca viu.
Se houver dados pessoais, como nomes e endereços de e-mail, o projeto precisa de base legal, finalidade definida e segurança, como exige a LGPD.
Etapa 4: escolher o tipo de aprendizado
| Tipo | Dados | Exemplo real de uso |
|---|---|---|
| Supervisionado | Exemplos com a resposta certa | Classificar spam, prever inadimplência |
| Não supervisionado | Exemplos sem rótulo | Agrupar clientes por comportamento, achar transações fora do padrão |
| Por reforço | Ações e recompensas | O programa de damas de Samuel, robôs, jogos |
| Autossupervisionado | O rótulo sai do próprio dado | Prever a próxima palavra, base dos modelos de linguagem |
O spam é um caso clássico de aprendizado supervisionado de classificação (prever uma categoria). Prever um número, como o preço de um imóvel, é regressão.
Etapa 5: começar com um modelo simples
A quarta regra do guia do Google é "mantenha o primeiro modelo simples e acerte a infraestrutura". Em dados organizados em tabela, algoritmos como regressão logística, árvores de decisão e gradient boosting costumam render bem, treinam rápido e são mais fáceis de explicar do que redes neurais. Redes neurais profundas brilham em imagem, áudio e texto, e são a base da IA generativa.
Um exemplo mínimo com a biblioteca scikit-learn, cuja versão estável em outubro de 2026 é a 1.9.1, lançada em setembro, segundo o site oficial. O código treina uma árvore de decisão para classificar flores em três espécies a partir de medidas:
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import classification_report

X, y = load_iris(return_X_y=True)
X_treino, X_teste, y_treino, y_teste = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

modelo = DecisionTreeClassifier(max_depth=3, random_state=42)
modelo.fit(X_treino, y_treino)

print(classification_report(y_teste, modelo.predict(X_teste)))
O train_test_split separa 30% dos dados para teste, o fit treina e o classification_report mostra precisão e recall por classe. O valor exato depende da divisão; o que importa é medir em dados que ficaram fora do treino. Se você ainda não programa, o roteiro está em como aprender a programar.
Etapa 6: avaliar sem se enganar
Dois erros clássicos aparecem aqui:
- Overfitting (sobreajuste): o modelo decora os exemplos de treino, inclusive o ruído, e vai mal em dados novos. Sinal típico: desempenho ótimo no treino e ruim no teste.
- Underfitting (subajuste): o modelo é simples demais e vai mal até no treino.
Um terceiro erro é mais traiçoeiro: o vazamento de dados. Acontece quando alguma informação do futuro ou da resposta entra nas características. Um modelo de inadimplência que usa a coluna "renegociou a dívida" vai parecer excelente no teste e falhar na vida real, porque essa informação só existe depois do calote.
Etapa 7: colocar em produção e vigiar
Treinar é a parte curta. Depois que o modelo entra em uso (a fase de inferência), aparecem problemas que o teste não mostrava:
- Diferença entre treino e uso: o guia do Google dedica várias regras a isso e recomenda registrar as características exatamente como chegam em produção para reaproveitá-las no treino.
- Deriva de dados: o mundo muda: surgem novos tipos de golpe, os hábitos de uso mudam, e um modelo que não é retreinado vai perdendo acerto.
- Adversários: em spam e fraude, há gente estudando o filtro para driblá-lo.
- Explicação de decisões: se o modelo decide sobre pessoas, como crédito, a LGPD garante o direito de pedir revisão de decisões automatizadas. O panorama regulatório está em regulação da IA em 2026.
Por isso projetos maduros retreinam modelos com frequência e acompanham métricas em produção, não só no laboratório.
Machine learning, deep learning e IA: onde cada um entra
Inteligência artificial é o campo inteiro. Machine learning é a abordagem de aprender com dados, hoje a mais usada dentro da IA. Deep learning é o machine learning feito com redes neurais de muitas camadas, que exigem mais dados e mais poder de processamento, normalmente GPUs. Modelos pequenos e dados em tabela rodam bem em um computador comum; o que muda é o hardware necessário para treinar redes grandes.
Fontes
- Google Workspace Blog. Ridding Gmail of 100 million more spam messages with TensorFlow (6/2/2019).
- IBM. Early games: Samuel Checkers.
- Google for Developers. Rules of Machine Learning.
- Google for Developers. Machine Learning Crash Course.
- scikit-learn. Documentação e notas de versão (versão 1.9.1, setembro de 2026).
- Mitchell, T. Machine Learning (McGraw-Hill, 1997).
- Presidência da República. Lei nº 13.709/2018 (LGPD).