Quando você pergunta a um assistente "qual é a capital da Austrália?", o modelo não consulta um banco de dados de capitais. Ele calcula, um pedaço de texto de cada vez, qual continuação é mais provável depois da sua pergunta. Na maioria das vezes isso produz "Canberra". Às vezes produz "Sydney", com a mesma segurança.
Os grandes modelos de linguagem, os LLMs (large language models), são redes neurais treinadas para essa previsão. Abaixo, a pergunta é acompanhada etapa por etapa, do texto digitado até a resposta, para mostrar onde estão a força e as falhas desses sistemas.
Etapa 1: o texto vira tokens
O modelo não lê letras nem palavras inteiras. Um componente chamado tokenizador corta o texto em tokens: palavras comuns, pedaços de palavras, espaços e pontuação. "Austrália" pode virar um ou mais tokens, dependendo do vocabulário do modelo.
A documentação da API Gemini, do Google, dá uma régua prática: um token equivale a cerca de 4 caracteres, e 100 tokens correspondem a algo entre 60 e 80 palavras em inglês. A proporção muda de idioma para idioma e de modelo para modelo, já que cada um tem seu próprio vocabulário.
Tokens também medem imagem, áudio e vídeo. Segundo a mesma documentação, consultada em outubro de 2026, uma imagem pequena custa 258 tokens, imagens maiores são divididas em blocos de 768 x 768 pixels com 258 tokens cada, o áudio consome 32 tokens por segundo e o vídeo, 263 tokens por segundo no processamento padrão. É por isso que as APIs cobram por milhão de tokens, e não por pergunta.
Etapa 2: cada token vira um vetor
Cada token é trocado por um embedding, uma lista de centenas ou milhares de números que posiciona o token em um espaço matemático. Tokens com usos parecidos ficam próximos: "Canberra" fica perto de outras capitais, "Austrália" perto de outros países.
Esses vetores não são escritos à mão. Eles são ajustados durante o treino, do mesmo jeito que os outros parâmetros do modelo, um processo explicado em o que é machine learning.
Etapa 3: a atenção relaciona tudo com tudo
Quase todos os LLMs atuais usam a arquitetura Transformer, apresentada por pesquisadores do Google em 2017 no artigo Attention Is All You Need. A peça central é o mecanismo de atenção: ao processar cada token, o modelo calcula quanto cada um dos outros tokens importa para ele.
Na frase "A prefeita disse que ela aprovaria o projeto", a atenção ajuda a ligar "ela" a "prefeita". Na nossa pergunta, liga "capital" a "Austrália". O modelo empilha dezenas de camadas de atenção, e a cada camada a representação de cada token fica mais rica em contexto.
Etapa 4: um token de cada vez
No fim das camadas, o modelo produz uma distribuição de probabilidades sobre todo o vocabulário para a próxima posição. "Canberra" pode receber probabilidade alta, "Sydney" alguma, e milhares de outros tokens quase nenhuma. Um token é sorteado conforme essas probabilidades, acrescentado ao texto, e o ciclo recomeça até o modelo emitir um sinal de fim.
O parâmetro temperatura controla o sorteio. Temperatura baixa favorece sempre o mais provável e deixa as respostas previsíveis; temperatura alta dá chance a tokens menos prováveis e produz mais variedade, e mais erros. Por isso a mesma pergunta pode receber respostas diferentes.
Muitos modelos recentes têm ainda um modo de raciocínio (chamado de thinking ou pensamento estendido): antes da resposta final, geram tokens de rascunho em que decompõem o problema. Esses tokens também são texto previsto, ocupam espaço na janela de contexto e são cobrados como saída, segundo a documentação da Anthropic.
Como o modelo chegou até aqui: o treino em três etapas
| Etapa | O que o modelo recebe | O que aprende |
|---|---|---|
| Pré-treino | Volumes enormes de texto público, livros e código | Prever o próximo token; com isso absorve gramática, fatos e estilos |
| Ajuste com instruções | Exemplos de pedidos e boas respostas, escritos ou escolhidos por pessoas | Seguir instruções em vez de só continuar o texto |
| Alinhamento com feedback | Comparações entre respostas, feitas por pessoas ou por outros modelos | Preferir respostas úteis, honestas e seguras |
O pré-treino é o exemplo mais conhecido de aprendizado autossupervisionado: o próprio texto fornece a resposta certa (a palavra seguinte). O artigo da OpenAI sobre o GPT-3, de 2020, mostrou que modelos grandes o bastante passam a resolver tarefas novas só com alguns exemplos no prompt. Em 2022, o trabalho sobre o InstructGPT descreveu o ajuste com feedback humano (RLHF), que transformou modelos de completar texto em assistentes de conversa.
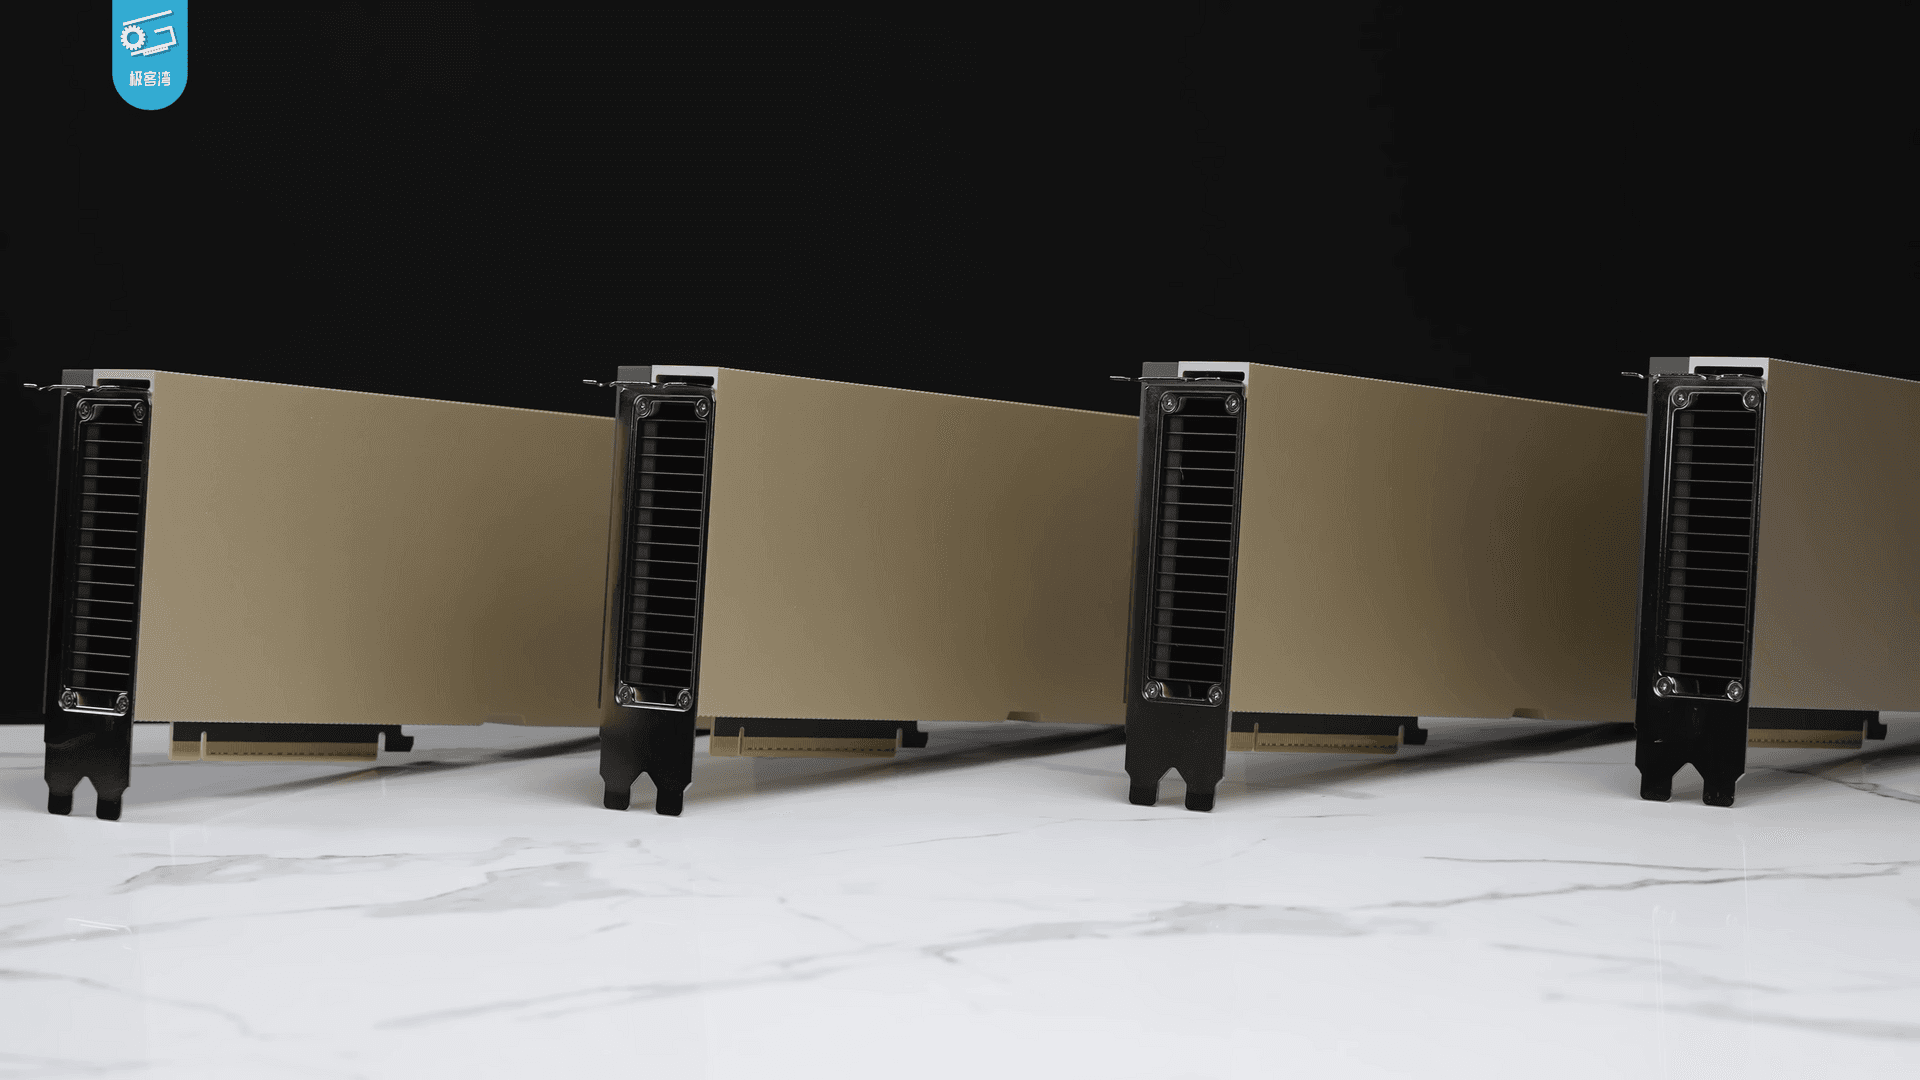
O treino exige grandes conjuntos de aceleradores trabalhando em paralelo, como as GPUs NVIDIA H100 da foto deste artigo. A etapa de uso, chamada de inferência, é bem mais leve, a ponto de modelos menores rodarem em um notebook, como mostramos em como rodar uma IA no seu computador com Ollama.
A janela de contexto: o que o modelo "vê"
O modelo só considera uma quantidade limitada de tokens por vez, a janela de contexto. Entram nela as instruções do sistema, todo o histórico da conversa, documentos anexados, resultados de ferramentas e a própria resposta em construção.
Em outubro de 2026, as documentações oficiais da Anthropic e do Google informam janelas de cerca de 1 milhão de tokens nos modelos Claude e Gemini mais recentes (1.048.576 no caso do Gemini). Modelos Claude anteriores, como o Sonnet 4.5, têm 200 mil.
Janela grande não significa leitura perfeita. A própria Anthropic avisa que, à medida que o número de tokens cresce, a precisão e a capacidade de recuperar informações caem, fenômeno que ela chama de context rot. Na prática, um contrato colado no meio de uma conversa longa pode ter cláusulas ignoradas.
Outro ponto: o modelo não aprende com a sua conversa. Seus parâmetros ficam congelados durante o uso. Se um serviço "lembra" de você em outra sessão, é porque guardou notas fora do modelo e as recoloca no contexto.
Por que ele respondeu "Sydney"
Uma resposta errada e fluente é chamada de alucinação. Em setembro de 2025, pesquisadores da OpenAI publicaram o artigo Why Language Models Hallucinate com um diagnóstico direto: os procedimentos de treino e de avaliação recompensam o chute em vez do reconhecimento de incerteza. Se um teste dá ponto para a resposta certa e zero para "não sei", chutar sempre compensa.
Somam-se a isso causas conhecidas:
- O objetivo é soar plausível, não verificar. Não existe uma etapa interna de checagem de fatos.
- Fatos raros têm pouco sinal nos dados. Datas de nascimento de pessoas pouco conhecidas, números de processos e citações exatas são terreno fértil para invenção.
- Data de corte. O modelo reflete o mundo até o fim do seu treino, a menos que receba informação nova no contexto.
- Forma igual para acerto e erro. O texto sai com a mesma confiança nos dois casos.
O que reduz o problema
- Busca e documentos no contexto (RAG): o sistema recupera trechos de fontes confiáveis e pede ao modelo que responda com base neles. A técnica foi descrita em 2020 por pesquisadores do Facebook AI.
- Ferramentas: calculadora para contas, busca para fatos recentes, consulta a bancos de dados para números.
- Instruções explícitas: pedir que o modelo cite a fonte e diga quando não sabe. Técnicas em como escrever bons prompts.
- Conferência humana de nomes, números, datas e referências antes de usar.
LLM, chatbot e agente não são a mesma coisa
O LLM é o modelo. O chatbot é o produto que coloca uma interface de conversa em volta dele, com instruções de sistema, filtros e, muitas vezes, busca na web. O agente usa o LLM para decidir ações e acionar ferramentas em sequência, tema de agentes de IA.
O mesmo modelo pode se comportar de forma bem diferente em produtos distintos, porque cada empresa monta o contexto de um jeito. As diferenças práticas entre os assistentes mais usados estão em ChatGPT, Claude e Gemini: diferenças.
Fontes
- Vaswani, A. et al. Attention Is All You Need (2017).
- Brown, T. et al. Language Models are Few-Shot Learners (2020).
- Ouyang, L. et al. Training language models to follow instructions with human feedback (2022).
- Lewis, P. et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020).
- Kalai, A. T. et al. Why Language Models Hallucinate (2025).
- Google AI for Developers. Understand and count tokens (consultado em outubro de 2026).
- Anthropic. Context windows (consultado em outubro de 2026).